今天看到這篇文章,加上近日對於整理筆記之厭倦,在想到底寫筆記是寫來幹嘛的?

那篇文章表示不用寫「資訊」,但以學習知識來說,我還是需要一點「重點整理」方便日後查找,尤其是一些從書上看來、稍微消化過但也還沒熟到整個記下來的部分。資訊的確幾乎都可以找 google 大神,但是重新 google 到的資訊可能跟我的印象有出入,還有一些眉眉角角不見得記得,有個地方作為資訊的集中地對我還是有用的。

只不過,有時候似乎會趨向小時候在課堂上抄寫筆記的狀況,像在抄書。這感覺就怪怪的,有時候分不清楚自己是在抄書還是那真是重點(好吧,我猜如果覺得很厭倦的話大概就是在抄書或者已經不需要寫了)。想著想著發現原來今年初寫過筆記這回事

以上是跟專業、學習知識有關的「筆記」。至於看其他書啊、聽演講啊之類的,我比較會寫心得感想,像那篇文章所說的第二種筆記。在專業有關的學習上,這種感想會在書裡變眉批,這裡一句、那裡一段的,有時候是疑問,有時候是吐槽(欸?),但這種亂七八糟的心得就不太會去整理了。

可能會慢慢增加對於專業領域的想法吧,我對時事或一些事情會有某些想法,但很奇怪,對於自身專業卻不太有自己的想法。

C++ 不像 Java 有 interface,這邊說的 interface 是所有 function 皆為 pure virtual function 的 abstract class。

interface 依然要有 virtual destructor,否則用 interface pointer 去砍 object 的時候會變成 undefined behavior。如果希望 interface 中的 virtual destructor 仍是 pure virtual,可以這樣寫:

1
2
3
4
5
6
7
class Interface
{
public:
virtual ~Interface() = 0;
};

inline Interface::~Interface() { }

由於只要有 class 繼承 Interface,Interface 的 destructor 就會被 derived class call 到,所以必須要有 definition 才不會 link error。

virtual destructor 另一個使用場合──希望訂一個 interface 但不想訂定其中要有什麼 function──不想訂 function 但又需要該 class 是 abstract class 時就可用 virtual destructor 達到目的。聽起來有點怪,我遇到這種狀況是希望有個 interface 可以代表某種類的 object,但是在 interface 的階段卻又無法確定 derived class 會有那些 function,最後因為覺得結構上不需要而沒有真的使用,不曉得有沒有其他更好的方法?

2018-12:現在看看覺得「希望訂一個 interface 但不想訂定其中要有什麼 function」的情況有點怪……又想不起來之前遇到什麼了……要訂 interface 至少要有基本 function,否則是否先不訂 interface、先做 class,等漸漸看到有共通的 function 時再訂定 interface?

Ref

看完《深入淺出物件導向分析與設計》的筆記,這篇概括整理用 OOAD 開發軟體的開發週期,沒有太多細節。

1. 搞清楚客戶想要什麼

跟客戶聊天,從模模糊糊中搞清楚他想要什麼。或者問可以決定要做什麼的人,不管那個人是 PM、PL 還是其他各種頭銜…

利用 Commonality 及 Variability 了解客戶想要什麼、軟體要做什麼。

老實講,我覺得這真是門藝術。

2. 建立 feature list 及 use case diagram

跟客戶聊完天、了解系統要做什麼後建立 feature list,表示整個系統的功能概觀。畫張 use case diagram 呈現使用者或其他系統使用這個系統的藍圖,既然是藍圖,當然不會有太細節的東西啦!feature list 是以功能面的角度看整個系統,use case diagram 則是以「使用」的角度來看整個系統。feature list 裡的功能不管直接或間接,得要能跟 use case diagram 的 use case 互相對應。

Use case diagram example:

到這裡,對整個軟體系統,還只有比較概略性的藍圖,還沒進到 detail,我們要盡可能延後 detail!

Domain Analysis

辨識、收集、組織及表示領域相關資訊的流程,根據既有系統與其開發歷程的研究、領域專家的知識、潛在理論、領域中的新興技術。

是段看不懂在寫什麼的文言文…好吧這種時候我承認原文比較好懂…

在我的理解裡,這部分包含 survey 相關技術,例如 framework 如何使用,包括分析、了解原有架構及既有程式碼、找出相關的物件、物件間關係與互動等等,也包含了解此系統相關的背景知識、相關流程等等,例如要做一個請假系統,得要了解請假流程。

用客戶能理解的語言跟方式描述問題以及系統,不要跟他講什麼 class、variable 就對了。簡單來說──「講人話」。

3. 設計架構

根據 feature list、use case diagram 跟現有程式碼等等資訊將大問題分解成多個各自負責不同功能的 module。組織這些 module 並決定從哪個 module 開始動工。這個階段的重點是建立做事情的順序以及減少風險,更多細節

如果有需要,套用 design pattern。design pattern 是解決特定問題的方式,能結構化程式,讓程式較易被理解、維護而且更有彈性。

4. 一個個處理小功能

將大問題分成許多小問題之後,準備各個擊破啦!

不同的開發方式:Feature driven & Use case driven development

4-1. 想小功能的 requirement,建立 requirement list

依照描述的需求建立需求清單。類似 feature list 的概念,只是小一點,著重在要處理的小功能有何需求,會比最開始的 feature 更進入細節事項。

需求不只包含客戶想要的,也包含當事情不按正常狀況來時系統依然要能正常運作。畢竟客戶通常希望當事情不如預期時,系統仍然能正常運作。可以從兩方面著手:

  1. 這個功能要拿來做什麼、該做什麼?
  2. 在出錯的情況中,系統要做些什麼事?

4-2. 寫 Use case

requirement 及 use case 要能互相對應,跟 feature 與 use case diagram 一樣。

因為系統是跑在真實世界,不是只跑在預期狀況中,要考慮出錯的狀況。但是呢,有時候系統遇到出錯狀況時「如何反應才是正常」不見得是工程師能決定的,所以,請騷擾請教可以決定這件事的人。

更多跟 Use case 有關的細節

4-3. 設計物件細節及物件間的關係

4-4. 實作

運用 OO 原則:

5. 測試

測試所有能想到的可能使用狀況跟不按規矩來的使用狀況。

unit test 已經有抽象上的「功能」觀念。unit test 一次只測一個小功能,但測一個小功能不等於測一個 function,也可能是測很多個 function 組合而成的「功能」。

在測試中要模擬 code 真正被使用的狀況跟情境,而不是測試簡單 call function 但實際上並不會這麼使用的狀況。

Murmur

這只是大通則,裡面很多細節是要依照 project 各自狀況不同有所改變的。雖然說是 OOAD 軟體開發週期,但以概念上來說我覺得前面的需求分析等等跟 OO 沒多大關係。

現在理解到程式設計到處都是 divide and conquer,小時候(?)不懂以為 divide and conquer 只存在 algorithm 裡……

最開始我很容易犯的毛病是一下子就想動手寫 code,然後搞得很崩潰,幾次之後就不會想這麼幹了。還有會一下子就掉進細節而且還出不來,難以維持以 big picture 的角度去看,就整個攪再一起,這點現在到底治好了沒我也不太確定…(欸)

雖然目前我只用到裡面的部分方法,但是似乎有個開發週期的框架後變得比較知道自己在幹嘛,腦子比較不會像果醬糊成一團。

commonality(共通性)跟 variability(變化性)算是觀念,可以套用到軟體開發的不同階段。

在釐清客戶需求的階段,commonality 可以想成軟體「像」什麼,也就是系統需要做的事。variability 則是軟體「不像」什麼,即系統不用處理的事。透過釐清系統像什麼、不像什麼,來了解客戶心中想要的系統究竟要做什麼事。

到了 design 及 implement 階段,分析 class 間的 commonality,可以將共同的部分抽到 base class。

很久很久以前(大概是還在用紙帶打洞的時代),會在 code 裡直接寫 variable 跟 function 所在的 address(我猜一開始說不定只有「要在哪裡取得資料」跟「要跳到哪裡繼續執行」的概念)。增加指令、修改程式後,會有很多 variable 及 function 的 address 被改變,像是中間多塞個指令就會讓後面東西 address 全改了,所以程式中所有 address 都需要重新調整(relocate)。

這種 relocate 工作太令人崩潰,於是有人想出 symbol 的概念──以符號代表某個 variable 或 function(其實就是取名字)。code 裡改用 symbol,不再直接寫 address。等程式要執行的時候再把 symbol 換成真正的 address。這就是最開始 linking 主要做的事。

隨著時代演進(?),程式規模越來越大,人們開始在一個程式中分許多 module 並且分別 compile。有多個 module 後 linking 就要處理跨 module 的 variable 及 function 引用,也就是將在其他 module 中的 variable 跟 function 的 address 填入 reference 到它們的地方。例如在 A module 裡 call B module 的 function foo(),就要在 A module 中填入 foo() 真正的 address。

如此一來,compile 階段可以不用知道 symbol 的 address,而且 module 也可以獨立 compile,等到 link 階段再由 linker 處理 symbol 及 address 的轉換。linker 就像是將多個 compile 好的 module 黏起來。

linking 主要過程:

  • Address and storage allocation
  • Symbol resolution
  • Relocation

object file 是 source code compile 後但尚未 link 的 binary 中間檔,通常跟可執行檔使用相同格式。object file 包含 compile 後的 machine code、data、symbol table、debug 資訊及字串等等。

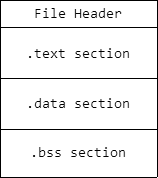
object file 以不同 section 儲存不同資訊。

Object File Overview

  • File Header 描述檔案屬性、section table
  • .text.code)section 裡放 code
  • .data section 放已經 initialize 的 global varible 及 static local variable
  • .bss section 記錄沒有 initialize 的 variable,先記著「有這個 variable」跟它的 size。但是因為 variable 還沒有 value,所以在 object file 裡不需要浪費空間去記錄 value。

Ref

Executable Format 主要有:

  • Windows 下的 PE(Portable Executable)
  • Linux 下的 ELF(Executable Linkable Format)

其他還有 Intel/Microsoft 的 OMF(Object Module Format)、Unix 的 a.out 以及 MS-DOS COM 格式等等。

除了可執行檔外,Dynamic Linking Library 跟 Static Linking Library 都是以 Executable Format 儲存。

ELF 標準中將使用 ELF 格式的檔案分成:

ELF file type Example
Relocatable File Linux 的 .o、Windows 的 .obj
Executable File /bin/bash、Windows 的 .exe
Shared Object File Linux 的 .so、Windows 的 .dll
Core Dump File Linux 的 core dump

ELF file structure

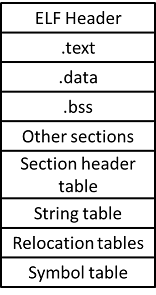
ELF 檔是由 header、一堆 section 及一堆 table 組成的,各 table 也是 section。

ELF structure

ELF Header

描述整個 ELF 檔的屬性,可用 readelf -h xxx 查看。

struct 定義在 /usr/inclue/elf.hElf32_Ehdr or Elf64_Ehdr

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
typedef struct
{
unsigned char e_ident[EI_NIDENT]; /* Magic number and other info */
Elf32_Half e_type; /* Object file type */
Elf32_Half e_machine; /* Architecture */
Elf32_Word e_version; /* Object file version */
Elf32_Addr e_entry; /* Entry point virtual address */
Elf32_Off e_phoff; /* Program header table file offset */
Elf32_Off e_shoff; /* Section header table file offset */
Elf32_Word e_flags; /* Processor-specific flags */
Elf32_Half e_ehsize; /* ELF header size in bytes */
Elf32_Half e_phentsize; /* Program header table entry size */
Elf32_Half e_phnum; /* Program header table entry count */
Elf32_Half e_shentsize; /* Section header table entry size */
Elf32_Half e_shnum; /* Section header table entry count */
Elf32_Half e_shstrndx; /* Section header string table index */
} Elf32_Ehdr;

e_ident 是 magic number 標示這是個 ELF 檔,前 4 個 byte 依序是 0x7f、0x45、0x4c、0x446,接著 3 個 byte 是 “ELF” 三個字母的 ASCII code。所有 ELF 檔前幾個 byte 都是這個內容。除此之外,幾乎所有可執行檔最開始幾個 byte 都是 magic number,供 OS 識別是哪種可執行檔。

e_phoff 表示程式執行時的入口位置,executable file 會填入 address,relocatable file 因為還會進行 relocate 所以值是 0。

從 section header table file offset e_shoff 可以知道 section table 所在位置,由 e_shentsizee_shnum 可以知道 section header table 的 element size 以及總共有多少 element。從 ELF header 可以找到 section header table,由於其他 table 也都是 section,可以再從 section header table 取得所有其他 section 及 table 的資訊。

Section Header Table

描述各 section 的屬性,可用 readelf -S xxx 查看。

一個以 struct Elf32_Shdr(又稱 section descriptor)為 element 的 array,array 的第一個 element 是 NULL,struct 定義在 /usr/include/elf.h。因為 section header table 是個 array,所以 ELF 檔有些地方會以 section 在 section table 中的 index 來 access 或表示該 section。

1
2
3
4
5
6
7
8
9
10
11
12
13
typedef struct
{
Elf32_Word sh_name; /* Section name (string tbl index) */
Elf32_Word sh_type; /* Section type */
Elf32_Word sh_flags; /* Section flags */
Elf32_Addr sh_addr; /* Section virtual addr at execution */
Elf32_Off sh_offset; /* Section file offset */
Elf32_Word sh_size; /* Section size in bytes */
Elf32_Word sh_link; /* Link to another section */
Elf32_Word sh_info; /* Additional section information */
Elf32_Word sh_addralign; /* Section alignment */
Elf32_Word sh_entsize; /* Entry size if section holds table */
} Elf32_Shdr;

如果一個 section 存在 ELF 檔中,由 sh_offsetsh_size 可以知道其所在位置及大小。section 屬性主要由 section type sh_type 及 section flags sh_flags 決定。

String Table

.strtab 以及 .shstrtab section。

將 ELF 檔裡所用的字串,如 variable name、function name、section name 等存在一個 array 中,以 '\0' 隔開,並以字串在 array 中的 offset 表示該字串。

Symbol Table

.symtab section,可用 readelf -s xxx 查看。

記錄 object file 所用到的 symbol。每個 symbol 有其對應的 symbol value,variable 及 function 的 symbol value 是它們的 address。

symbol table 是以 struct Elf32_Sym 為 element 的 array,Elf32_Sym 一樣定義在 /usr/include/elf.h

1
2
3
4
5
6
7
8
9
typedef struct
{
Elf32_Word st_name; /* Symbol name (string tbl index) */
Elf32_Addr st_value; /* Symbol value */
Elf32_Word st_size; /* Symbol size */
unsigned char st_info; /* Symbol type and binding */
unsigned char st_other; /* Symbol visibility */
Elf32_Section st_shndx; /* Section index */
} Elf32_Sym;

對 linking 較重要的兩種 symbol:global symbol 及 external symbol。global symbol 是定義在此 object file 中並且會讓其他 object file 使用到的 symbol,external symbol 則是此 object file reference 到的其他 object file 中的 symbol。簡單講就是給別人用跟用別人的 symbol,有點繞舌。
Relocation tables

存 relocation 的資訊,.rel.text section。每個需要 relocate 的 section 都會有一個 relocation table。

relocation 可參考 Static Link

Linking View and Execuion View

上述以 section 來劃分 ELF 內容的角度是 Linking View

ELF 在 mapping 到 virtual address space 時是以 page 為單位,如果 section 的大小不是 page 大小的整數倍又以 section 為單位進行 mapping,會浪費許多 memory。load ELF 時 OS 只在乎 section 的屬性如可讀、可寫、可執行,OS 不在乎 section 的內容,為了節省記憶體空間延伸出「將屬性相同的 section 合併成一個 segment,再對應到 virtual address space」的方式。linker 在 link object file 時會盡量將相同屬性的 section 放在一起。

segment 是以 load 的角度劃分 ELF,也就是 Execution View

Ref

定義演算法家族,將個別演算法封裝起來,讓它們可以互相替換。此 pattern 讓演算法的變動不會影響到使用演算法的部分。

Strategy pattern 是一種定義一系列演算法的方法,所有演算法完成的都是相同的工作,只是實作不同,它可以以相同的方式 call 所有演算法,減少了各種演算法 class 與使用演算法的 class 間的耦合。

例子:最短路徑搜尋

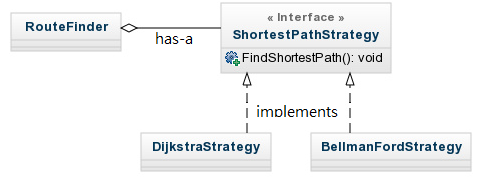
Strategy Pattern 最短路徑搜尋 class diagram

將 shortest path algorithm 封裝起來,讓 RouteFinder 使用。RouteFinder 使用 ShortestPathStrategy 找 shortest path(RouteFinder 將找路徑的工作 delegate 給 ShortestPathStrategy),ShortestPathStrategy 的 instance 則依據使用哪種 algorithm 決定。

有新的 algorithm 或 strategy 時只要 implement ShortestPathStrategy 並換掉 RouteFinder 使用的 instance 即可。

使用 RouteFinder 的 client code 跟演算法 strategy 的 class 就是分開、不互相耦合的。

Ref

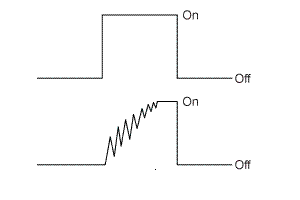
機械式開關切換時訊號會有 bounce(彈跳)現象。

switch bounce

上圖為理想狀況,下圖為實際上有 bounce 的狀況。bounce 持續時間約為 10~20 ms。

程式在 bounce 期間會讀取到 bounce 的訊號造成判斷錯誤。例如按一下按鈕開關我們期望程式只讀到一次 on 的訊號,bounce 會造成程式讀到很多次 on 的訊號。

解決方式軟體及硬體皆有,硬體的我看不懂所以這裡只說軟體。(欸)

軟體解決方式:不處理 bounce 時間內的訊號。「不處理」的實際做法可以自己硬寫也可以在 add_event_detect() 裡設定。

圖片來源:http://www.bbc.co.uk/schools/gcsebitesize/design/electronics/switchesrev2.shtml

接 button、switch 時會用到。(看到 button 這字想到的是 GUI 上的…)

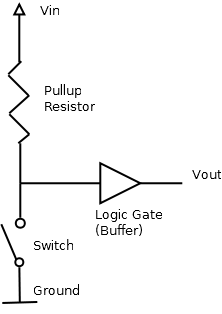
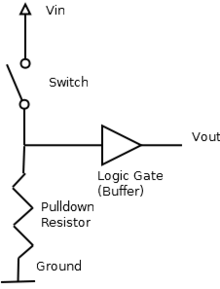
電路中希望維持一個電位基準值,好判斷某個電壓值是 0 還是 1。pull-up 跟 pull-down 電阻就是用來維持基準電位的,如果電路沒有接個東西,程式會讀到雜訊(亂數值)。

Pull-up resistor

switch 斷開時上半部的電路是通的,logic gate 會讀到較高的電位。switch 接上後,logic gate 的電位會變低(從電流來看是下半部電路會接通,以至於電位會改變)。如果認定 switch 接上是邏輯的 1 則 logic gate 是低電位時表示邏輯的 1,高電位表示邏輯的 0。

Pull-down resistor

pull-down 電阻是反過來,switch 斷開時 logic gate 會讀到低電位,接上後是高電位。所以高電位表示邏輯 1,低電位表示邏輯 0。

接 Raspberry Pi 時,上面說的 logic gate 就是 Raspberry Pi 的 GPIO pin。

murmur:被高低電位搞得頭有點暈,不太確定那個電流的理解對不對?沒搞得很懂 logic gate 在乎的是電位還是電位差……我的電路學只有高中程度啊……Orz

圖片來源及 Ref: